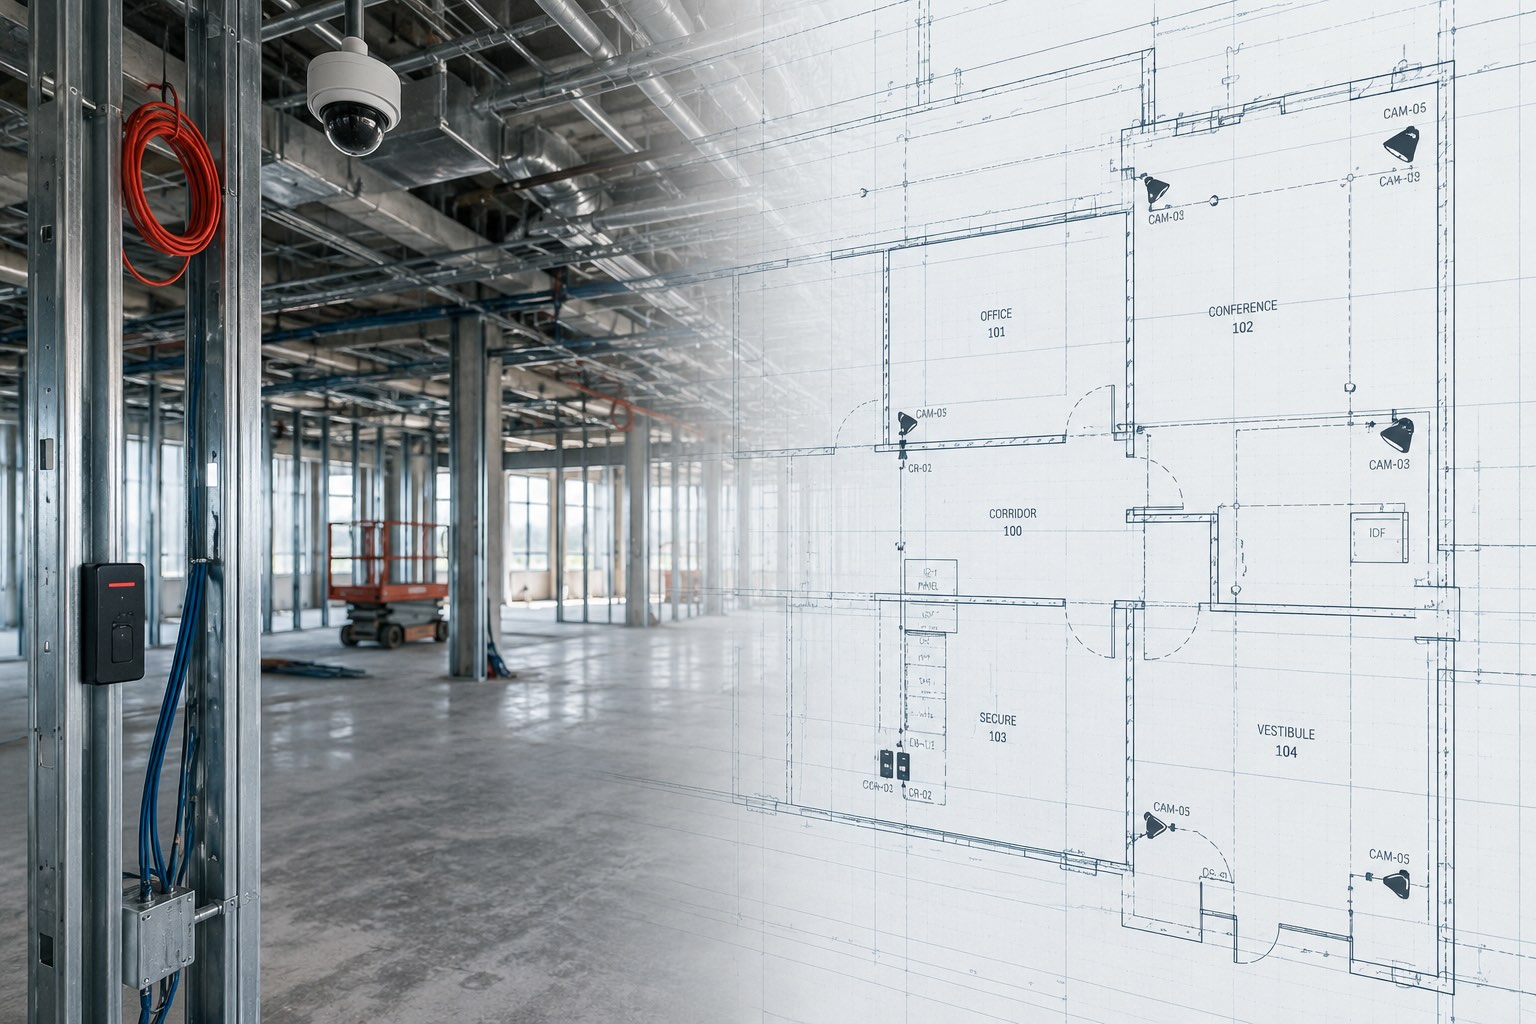
What Field Experience Brings to Security System Design
Field experience adds practical insight to security design, helping improve constructability, coordination and maintenance...

La inteligencia artificial está llevando al límite la capacidad de nuestros centros de datos. Ese fue el mensaje claro en Hot Chips 2025, la conferencia anual donde diseñadores de chips, arquitectos de sistemas e investigadores revelan lo que sigue en hardware de computación. Este año, la conclusión fue simple e ineludible: la física se ha convertido en la principal restricción para el progreso. Si las organizaciones quieren una IA más inteligente y rápida, deben reimaginar cómo se mueven los bits, cómo escalan las redes y con qué eficiencia la energía se transforma en inteligencia.
Nuestro equipo asistió al evento y regresó con energía y entusiasmo por la próxima generación de computación y redes. El trabajo que se está realizando en silicio, óptica, memoria y tecnología de interconexión está a punto de transformar la forma en que se construyen los centros de datos. Aquí presentamos las perspectivas que consideramos más relevantes para propietarios, desarrolladores y operadores de infraestructura de IA.
En varias presentaciones, los ponentes afirmaron que el centro de datos es ahora el verdadero ordenador. No la CPU. No la GPU. No el rack. El edificio completo. Las cargas de trabajo de IA dependen de clústeres masivos que se comportan como una sola máquina, distribuyendo memoria, computación y refrigeración por todo el espacio. Para que esos clústeres sean útiles, cada elemento del entorno debe escalar de forma conjunta. Las redes, el almacenamiento, la refrigeración y el suministro eléctrico se están convirtiendo en componentes programables dentro de un sistema estrechamente coordinado.
Los modelos de IA tampoco se están reduciendo. Están aumentando de tamaño porque la ventana de contexto debe crecer para que los modelos de IA sean más útiles. El mecanismo de atención que sustenta los modelos de IA basados en transformadores debe crecer exponencialmente en tamaño según la ventana de contexto. Esto significa que los modelos más útiles consumen más memoria, pero hay menos espacio físico en el chip para colocarla. La única forma de obtener más memoria es añadir más nodos de computación en un clúster, lo que requiere un ancho de banda de interconexión mucho mayor. Las organizaciones que impulsan los avances en capacidad de computación están limitadas por la capacidad de mover información entre chips. Por eso, las redes son ahora el cuello de botella bajo el escrutinio de ingeniería más intenso.
El tema más emocionante fue la red fotónica: el uso de fotones en lugar de electrones para mover datos dentro y entre sistemas de computación. La fotónica se ha visto durante mucho tiempo como una tecnología del futuro, pero Hot Chips dejó algo claro como el agua: la luz es más rápida.
Las interconexiones fotónicas transmiten datos utilizando mucha menos energía por bit en comparación con la señalización eléctrica. Incluso las pequeñas mejoras son dignas de celebrar a hiperescala, pero los defensores demostraron niveles de consumo de energía un orden de magnitud menor que los sistemas actuales.
Nvidia presentó el nuevo hardware SpectrumX que utiliza moduladores de anillo micro para controlar la luz a nivel de chip. El resultado permite tejidos de conmutación a gran escala con un consumo de energía significativamente reducido en los transceptores mediante el uso de fuentes láser externas. Varias empresas emergentes también mostraron desarrollos innovadores, incluyendo prototipos de silicio que soportan decenas de terabits por segundo de ancho de banda óptico directamente en la interfaz del chip.
¿Qué significa esto para el diseño de centros de datos? Fibra por todas partes. La próxima generación de clústeres de GPU requerirá de 10 a 30 veces más densidad de fibra por dispositivo que las implementaciones actuales. La gestión de cables, la planificación de rutas y la estrategia de conectores se convertirán en desafíos arquitectónicos centrales. Por otro lado, la mayor densidad permitirá que las empresas con menos espacio disponible puedan instalar clústeres de entrenamiento de IA con una capacidad de computación que hoy requeriría una instalación dedicada.
No hubo ambigüedad sobre la aplicación estrella para las GPU y los conmutadores. Cada sesión, cada hoja de ruta y cada concepto de futuro giraba en torno a la inteligencia artificial. La IA generativa y la IA basada en agentes requieren enormes recursos computacionales, que dependen en gran medida del acceso a memoria paralela de alta velocidad.
El acceso remoto directo a memoria (RDMA) es ahora la tecnología fundamental para los grandes clústeres de entrenamiento de IA. RDMA permite a los aceleradores leer y escribir directamente en la memoria de otros a través de la red. Reduce la sobrecarga y aumenta el rendimiento, pero también crea un entorno de computación altamente acoplado. Los clústeres de entrenamiento no toleran la latencia. Los fallos se propagan al instante. Cualquier enlace lento retrasa todo el sistema.
Las arquitecturas de LLM hacen que este desafío sea aún más intenso. Las capas de atención de múltiples cabezales requieren que todas las salidas se recopilen antes de que un modelo pueda avanzar. Si una GPU termina tarde, todas las demás esperan. Si un enlace pierde paquetes, la precisión cae. El sistema general es tan fuerte como su interconexión más débil. Además, el gasto de capital inicial en redundancia de computación y conectividad reduce el riesgo del gasto operativo frente a fallos de hardware.
Esto demuestra una verdad sencilla: la conectividad es computación.
El rendimiento requiere energía. Mucha. Los clústeres de IA ya están llevando las densidades de los racks hacia la clase de 100 kilovatios. La refrigeración líquida ya no es opcional. El peso de los racks también está aumentando, lo que hace que la coordinación estructural sea cada vez más crítica.
Los principales operadores de la nube están considerando distribuir corriente continua de mayor voltaje directamente a los racks en lugar de depender de la conversión en fila. Esto liberaría valiosas unidades de rack para la computación y reduciría el desperdicio térmico de la electrónica de potencia. Cuando cada centímetro cúbico del rack debe soportar el entrenamiento o la inferencia, los operadores quieren menos componentes auxiliares consumiendo espacio.
Los clústeres de entrenamiento llave en mano se están convirtiendo rápidamente en la norma para las organizaciones que desean avanzar con rapidez. Las arquitecturas de referencia de Nvidia, como NVL72, proporcionan una base probada que reduce el riesgo de integración y el tiempo de implementación. Sin embargo, los operadores a gran escala con objetivos únicos siguen ajustando las referencias o creando arquitecturas personalizadas. El clúster Catalina de Meta se desvía de los estándares de Nvidia. Google sigue apostando por su estrategia interna de TPU.
La conclusión es que la industria seguirá dividida. La mayoría de los centros de datos seguirán ecosistemas de proveedores estrechamente integrados. Las plataformas más grandes buscarán ventajas de optimización con sistemas a medida. Los diseñadores e integradores deben dar soporte a ambas vías.
La conferencia destacó áreas específicas en las que los propietarios dependerán cada vez más de socios expertos:
La infraestructura de IA continúa su ritmo de rápida evolución. Los primeros usuarios ya están diseñando en torno a la fotónica, el rendimiento extremo de RDMA y densidades de potencia sin precedentes. Muchos operadores seguirán sus pasos en los próximos ciclos de renovación.
Los centros de datos se están convirtiendo en computadoras gigantes y cohesivas diseñadas para entrenar y desplegar inteligencia a gran escala. Los ganadores en esta nueva era serán las organizaciones que adopten estos cambios desde el principio y diseñen instalaciones que sigan el ritmo de la innovación. TEECOM está listo para ayudarles a lograrlo. Contacte a Tyler Kvochick hoy mismo para profundizar en estas ideas.
Tyler Kvochick es director de investigación en TEECOM, donde lidera el desarrollo de plataformas innovadoras de diseño de sistemas para mejorar la calidad y la eficiencia en los proyectos de la empresa. Con una maestría en arquitectura por la Universidad de Princeton y experiencia como desarrollador de software en empresas de tecnología de la construcción y análisis ambiental, Tyler combina el pensamiento computacional y de diseño para eliminar errores, la pérdida de información y la ambigüedad para nuestros clientes.
Stay ahead of the curve with our latest blog posts on industry trends, thought leadership, employee stories, and expert insights.