What Field Experience Brings to Security System Design
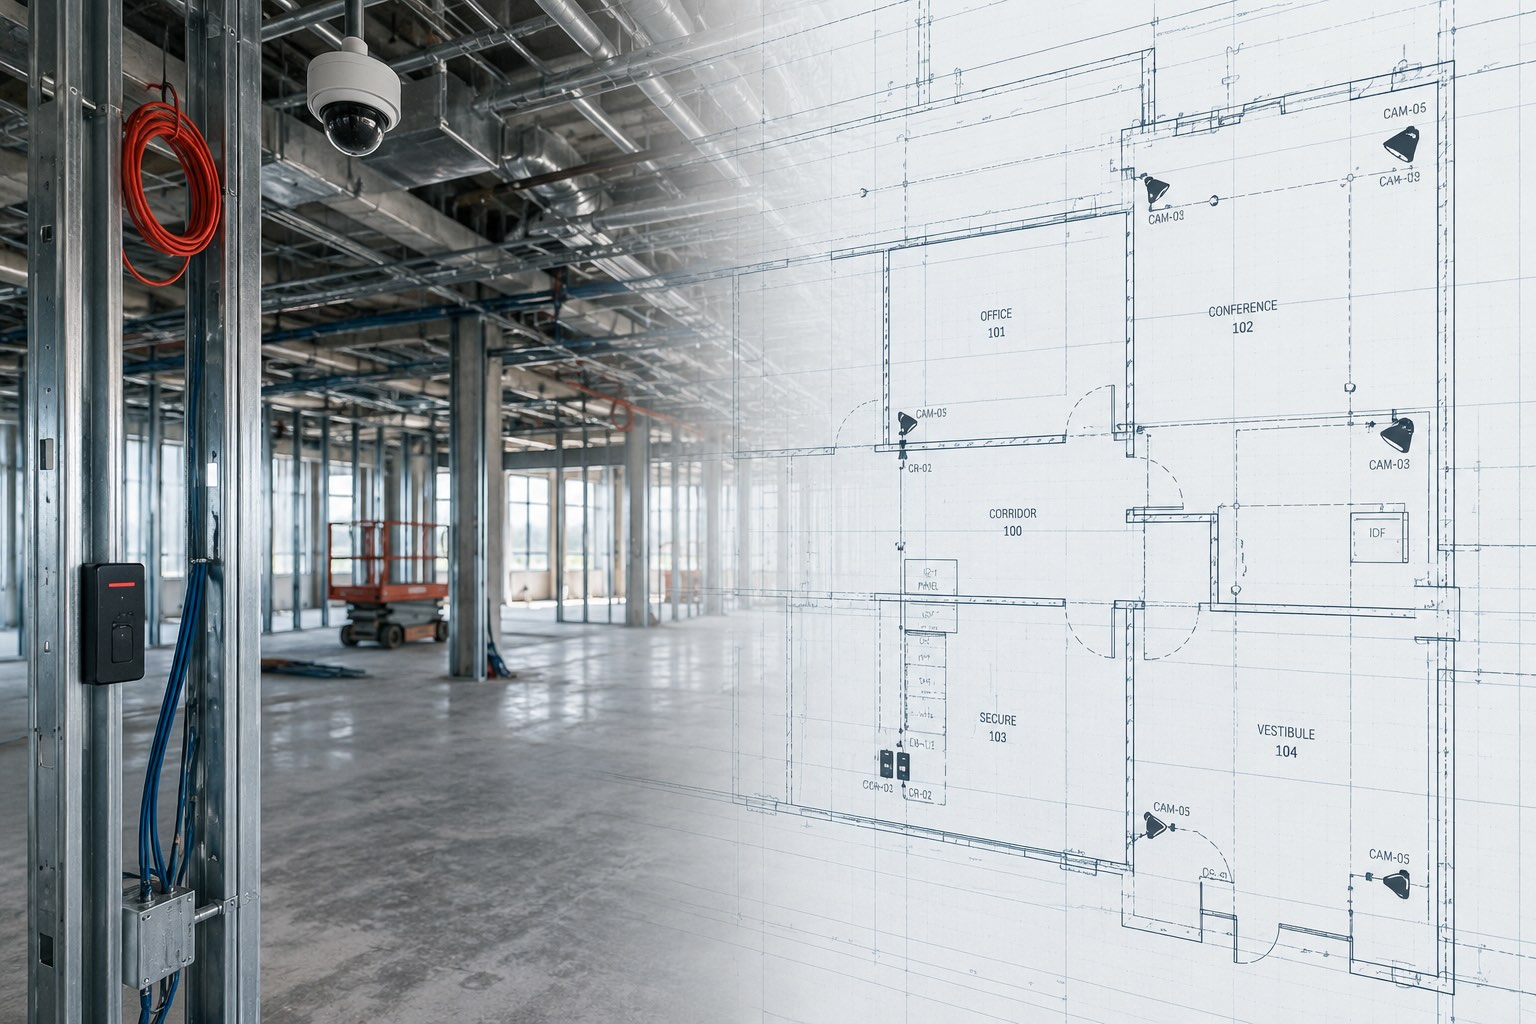
Field experience adds practical insight to security design, helping improve constructability, coordination and maintenance...

L'intelligence artificielle repousse les limites de ce que nos centres de données peuvent accomplir. C'était le message clair de Hot Chips 2025, la conférence annuelle où concepteurs de puces, architectes système et chercheurs dévoilent l'avenir du matériel informatique. Cette année, la conclusion était simple et incontournable : la physique est devenue la principale contrainte du progrès. Si les organisations veulent une IA plus intelligente et plus rapide, elles doivent repenser la circulation des bits, la mise à l'échelle des réseaux et l'efficacité de la conversion de l'énergie en intelligence.
Notre équipe a assisté à l'événement et en est revenue enthousiaste quant à la prochaine génération de calcul et de mise en réseau. Les avancées dans les domaines du silicium, de l'optique, de la mémoire et de la technologie d'interconnexion sont sur le point de transformer la conception des centres de données. Voici les points qui nous semblent essentiels pour les propriétaires, les développeurs et les exploitants d'infrastructures d'IA.
Lors de plusieurs présentations, les intervenants ont affirmé que le centre de données est désormais le véritable ordinateur. Pas le processeur. Pas le GPU. Pas la baie. Le bâtiment tout entier. Les charges de travail liées à l'IA reposent sur des clusters massifs qui se comportent comme une machine unique, distribuant la mémoire, le calcul et le refroidissement dans tout l'espace. Pour que ces clusters soient efficaces, chaque élément de l'environnement doit évoluer de concert. Le réseau, le stockage, le refroidissement et l'alimentation électrique deviennent des composants programmables au sein d'un système étroitement coordonné.
Les modèles d'IA ne rétrécissent pas non plus. Ils voient leur taille exploser car la fenêtre de contexte doit s'élargir pour que les modèles d'IA gagnent en utilité. Le mécanisme d'attention qui sous-tend les modèles d'IA basés sur les transformeurs doit croître de manière exponentielle avec la taille de la fenêtre de contexte. Cela signifie que des modèles plus utiles consomment davantage de mémoire, alors que l'espace physique disponible sur la puce pour intégrer cette mémoire diminue. La seule solution pour obtenir plus de mémoire est d'ajouter des nœuds de calcul dans un cluster, ce qui nécessite une bande passante d'interconnexion bien plus importante. Les organisations qui pilotent les avancées en matière de capacité de calcul sont limitées par leur capacité à transférer des informations entre les puces. C'est pourquoi le réseau est désormais le goulot d'étranglement faisant l'objet de l'examen technique le plus rigoureux.
Le thème le plus passionnant a été celui de la mise en réseau photonique : utiliser des photons plutôt que des électrons pour déplacer les données à l'intérieur et entre les systèmes de calcul. La photonique a longtemps été considérée comme une technologie d'avenir, mais Hot Chips a rendu une chose évidente : la lumière est plus rapide.
Les interconnexions photoniques transmettent les données en utilisant beaucoup moins d'énergie par bit que la signalisation électrique. Même de petites améliorations méritent d'être soulignées à l'échelle hyperscale, mais les partisans de cette technologie ont démontré des consommations d'énergie inférieures d'un ordre de grandeur à celles des systèmes actuels.
Nvidia a présenté son nouveau matériel SpectrumX qui utilise des modulateurs en anneau pour contrôler la lumière au niveau de la puce. Le résultat permet de créer des structures de commutation à grande échelle avec une consommation d'énergie considérablement réduite grâce à l'utilisation de sources laser externes pour les émetteurs-récepteurs. Plusieurs startups ont également dévoilé des avancées majeures, notamment des prototypes de silicium capables de supporter des dizaines de térabits par seconde de bande passante optique directement au niveau de l'interface de la puce.
Qu'est-ce que cela signifie pour la conception des centres de données ? De la fibre partout. La prochaine génération de clusters GPU nécessitera une densité de fibre 10 à 30 fois supérieure par appareil par rapport aux déploiements actuels. La gestion des câbles, la planification des chemins et la stratégie de connectivité deviendront des défis architecturaux centraux. À l'inverse, cette densité accrue permettra aux entreprises disposant de moins d'espace d'installer des clusters d'entraînement d'IA avec une capacité de calcul qui nécessiterait aujourd'hui un site dédié.
Il n'y avait aucune ambiguïté quant à l'application phare pour les GPU et les commutateurs. Chaque session, chaque feuille de route et chaque concept prospectif tournaient autour de l'intelligence artificielle. L'IA générative et l'IA basée sur des agents nécessitent des ressources informatiques énormes, qui dépendent fortement d'un accès mémoire parallèle à haute vitesse.
L'accès direct à la mémoire à distance (RDMA) est désormais la technologie de base des grands clusters d'entraînement d'IA. Le RDMA permet aux accélérateurs de lire et d'écrire directement dans la mémoire des autres via le réseau. Cela réduit la surcharge et augmente le débit, mais crée également un environnement de calcul hautement couplé. Les clusters d'entraînement ne tolèrent pas la latence. Les pannes se propagent instantanément. Le moindre lien lent ralentit l'ensemble du système.
Les architectures LLM rendent ce défi encore plus intense. Les couches d'attention multi-têtes exigent que toutes les sorties soient collectées avant qu'un modèle puisse progresser. Si un GPU termine en retard, tous les autres attendent. Si un lien perd des paquets, la précision chute. Le système global n'est aussi fort que son interconnexion la plus faible. De plus, les dépenses d'investissement initiales dans la redondance du calcul et de la connectivité permettent de réduire les risques opérationnels liés aux pannes matérielles.
Cela illustre une vérité simple : la connectivité, c'est de la puissance de calcul.
La performance exige de l'énergie. Beaucoup d'énergie. Les clusters d'IA poussent déjà les densités en rack vers la classe des 100 kilowatts. Le refroidissement liquide n'est plus une option. Le poids des racks augmente également, ce qui rend la coordination structurelle plus critique que jamais.
Les principaux opérateurs cloud envisagent désormais de distribuer le courant continu haute tension directement aux racks plutôt que de dépendre d'une conversion en rangée. Cela libérerait de précieuses unités de rack pour le calcul et réduirait les pertes thermiques liées à l'électronique de puissance. Lorsque chaque centimètre cube du rack doit servir à l'entraînement ou à l'inférence, les opérateurs cherchent à réduire le nombre de composants auxiliaires encombrants.
Les clusters d'entraînement « clés en main » deviennent rapidement la norme pour les organisations souhaitant agir vite. Les architectures de référence Nvidia, telles que NVL72, offrent une base éprouvée qui réduit les risques d'intégration et les délais de déploiement. Cependant, les opérateurs à grande échelle ayant des objectifs spécifiques continuent d'ajuster ces références ou de concevoir des architectures sur mesure. Le cluster Catalina de Meta s'écarte des standards de Nvidia. Google, quant à lui, reste fidèle à sa stratégie interne de TPU.
En résumé, le secteur restera divisé. La plupart des centres de données suivront des écosystèmes de fournisseurs étroitement intégrés. Les plus grandes plateformes chercheront à optimiser leurs avantages grâce à des systèmes sur mesure. Les concepteurs et intégrateurs doivent être en mesure de soutenir ces deux approches.
La conférence a mis en lumière des domaines spécifiques où les propriétaires s'appuieront de plus en plus sur des partenaires experts :
L'infrastructure IA poursuit son évolution rapide. Les pionniers conçoivent déjà leurs systèmes autour de la photonique, de performances RDMA extrêmes et de densités énergétiques sans précédent. De nombreux opérateurs suivront le mouvement au cours des prochains cycles de renouvellement.
Les centres de données deviennent des ordinateurs géants et cohérents, conçus pour entraîner et déployer l'intelligence à grande échelle. Les gagnants de cette nouvelle ère seront les organisations qui adopteront ces changements précocement et concevront des installations au rythme de l'innovation. TEECOM est prêt à les accompagner dans cette voie. Contactez Tyler Kvochick dès aujourd'hui pour approfondir ces réflexions.
Tyler Kvochick est directeur de la recherche chez TEECOM, où il dirige le développement de plateformes de conception de systèmes innovantes visant à améliorer la qualité et l'efficacité des projets de l'entreprise. Titulaire d'un master en architecture de l'université de Princeton et fort d'une expérience de développeur logiciel dans les secteurs de la construction technologique et de l'analyse environnementale, Tyler allie pensée computationnelle et design pour éliminer les erreurs, les pertes d'informations et les ambiguïtés pour nos clients.
Stay ahead of the curve with our latest blog posts on industry trends, thought leadership, employee stories, and expert insights.